
Clasificación privada: procesamiento y respaldo
La clasificación privada de correo depende del flujo completo de datos, no solo del proveedor o modelo. La aplicación alojada accede a información de mensajes para funcionar.
Qué datos se usan
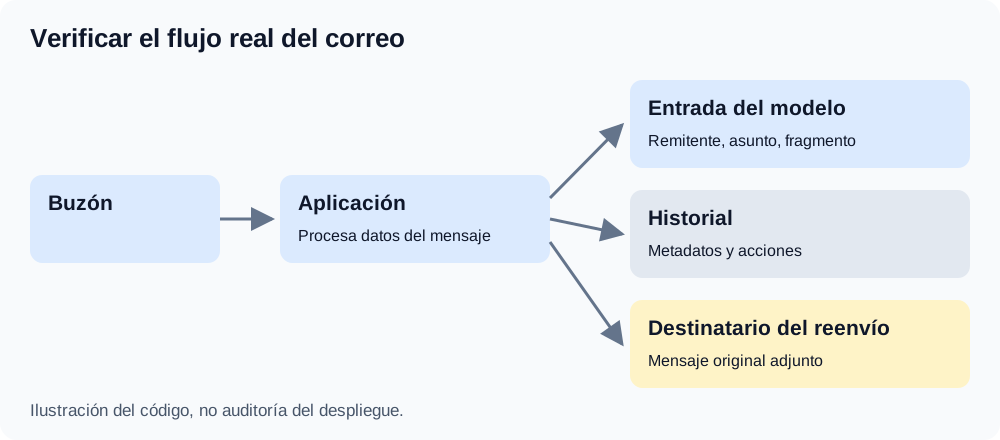
El clasificador prepara remitente, asunto y hasta 1.000 caracteres de un fragmento. Las categorías de remitentes usan muestras de hasta 500 caracteres cada una. Esos límites no describen todo el procesamiento; obtención y reenvío tienen otros requisitos.
El historial conserva metadatos y acciones, no una copia completa del cuerpo. El asunto puede contener datos personales o confidenciales. Revisa registros, copias y conservación de proveedores reales.
¿Un modelo propio hace todo local?
No. No cambia la ubicación de la aplicación alojada. Un endpoint puede tener un proveedor predeterminado de respaldo y usar otro modelo si falla. Los ajustes de producción rechazan actualmente direcciones privadas y de bucle local.
Para procesamiento solo local, un administrador debe verificar aplicación, modelo, red y cadena completa de proveedores. Prueba funcionamiento y caída con datos ficticios. Una URL local no demuestra inferencia exclusivamente local.
Decide aparte reenvío y recuperación
El reenvío con resumen adjunta el original. Verifica autorización del destinatario. Deshacer un movimiento no recupera esa copia. El historial no deshace eliminaciones permanentes.
Usa reglas exactas cuando basten o prueba una categoría concreta sin correo confidencial. Incluye coincidencias, exclusiones y ambigüedades. Contactos y compras no se conocen automáticamente.
Consulta modelo, reenvíos y flujo de datos. Describe el producto, no una evaluación jurídica de conformidad.
¿Listo para poner tu bandeja en piloto automático?
Empezar gratis